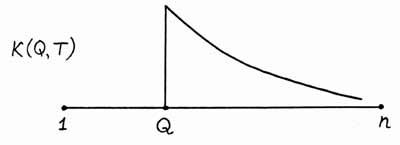
Математические методы новой хронологии. Метод упорядочивания исторических текстов во времениПродолжаем знакомиться с математической основой новой хронологии. Начало. МЕТОД ЛОКАЛЬНЫХ МАКСИМУМОВ. Продолжение. МЕТОД РАСПОЗНАВАНИЯ И ДАТИРОВАНИЯ ДИНАСТИЙ ПРАВИТЕЛЕЙ. Материал подготовлен на основе главы 5 книги А.Т.ФОМЕНКО «Основания истории» МАТЕМАТИКО-СТАТИСТИЧЕСКИЕ МЕТОДЫ ДАТИРОВАНИЯ ДРЕВНИХ СОБЫТИЙ http://chronologia.org/xpon1/05.html ПРИНЦИП ЗАТУХАНИЯ ЧАСТОТ. МЕТОД УПОРЯДОЧИВАНИЯ ИСТОРИЧЕСКИХ ТЕКСТОВ ВО ВРЕМЕНИ. Настоящий метод позволяет находить хронологически правильный порядок отдельных фрагментов текста, обнаруживать в нем дубликаты на основе анализа, например, совокупности собственных имен, упомянутых в тексте. Как и в предыдущих методиках, цель - создание метода датировки, основанного на численных, КОЛИЧЕСТВЕННЫХ характеристиках текстов и не обязательно требующего анализа смыслового содержания текстов, которое может быть весьма многозначно и расплывчато. Если в документе упомянуты какие-либо "знаменитые", ранее известные нам персонажи, описанные в других, уже датированных хрониках, то это позволяет датировать описанные в тексте события. Однако если такое отождествление сразу не удается и если, кроме того, описаны события нескольких поколений с большим количеством ранее неизвестных действующих лиц, то задача установления тождества персонажей с ранее известными усложняется. Для краткости назовем фрагмент текста, описывающий события одного поколения, "главой-поколением". Будем считать, что средняя длительность одного "поколения" - это средняя длительность правления реальных царей, зафиксированных в дошедших до нас летописях. Эта СРЕДНЯЯ ДЛИТЕЛЬНОСТЬ ПРАВЛЕНИЯ ЦАРЕЙ была вычислена при обработке хронологических таблиц Блера [76]. Она оказалась равной 17,1 года [884]. При работе с реальными историческими текстами выделение в них "глав-поколений" иногда наталкивается на трудности. В таких случаях ограничимся лишь приблизительным разбиением текста на последовательные фрагменты. Пусть летопись Х описывает события на достаточно большом интервале времени (А,В), на протяжении которого менялось по крайней мере несколько поколений персонажей. Пусть летопись Х разбита на "главы-поколения" Х(Т), где Т - порядковый номер поколения, описанного во фрагменте Х(Т) в той нумерации "глав", которая фиксирована в тексте. Возникает вопрос: ПРАВИЛЬНО ЛИ занумерованы, упорядочены эти "главы-поколения" в летописи? Или же, если эта нумерация утрачена или сомнительна, то КАК ЕЕ ВОССТАНОВИТЬ? Другими словами, как правильно расположить во времени "главы" друг относительно друга? Оказывается, для реальных исторических текстов в подавляющем большинстве случаев выполняется следующая "формула"-правило: полное имя = персонаж. Это означает следующее. Пусть интервал времени, описываемый летописцем, достаточно велик, например составляет несколько десятков или сотен лет. Тогда, - как было проверено в результате анализа большого набора исторических документов, - в подавляющем большинстве случаев РАЗНЫЕ ПЕРСОНАЖИ имеют в одном и том же тексте РАЗНЫЕ ПОЛНЫЕ ИМЕНА. Полное имя может состоять из нескольких слов, например, Карл Плешивый. Другими словами, ЧИСЛО РАЗНЫХ ЛИЦ С ОДИНАКОВЫМИ ПОЛНЫМИ ИМЕНАМИ НИЧТОЖНО МАЛО ПО СРАВНЕНИЮ С КОЛИЧЕСТВОМ ВСЕХ ПЕРСОНАЖЕЙ. Это верно для всех нескольких сотен исследованных нами исторических текстов, описывающих Рим, Грецию, Германию, Италию, Россию, Англию и т.д. Ничего удивительного в этом нет. В самом деле, летописец заинтересован в различении разных персонажей, чтобы избежать путаницы. Простейший способ добиться этого - присвоить разным лицам разные полные имена. Это простое психологическое обстоятельство и подтверждается подсчетами. Сформулируем теперь ПРИНЦИП ЗАТУХАНИЯ ЧАСТОТ, описывающий хронологически правильный порядок "глав-поколений". При правильной нумерации "глав-поколений" летописец, ПЕРЕХОДЯ ОТ ОПИСАНИЯ ОДНОГО ПОКОЛЕНИЯ К СЛЕДУЮЩЕМУ, СМЕНЯЕТ И ПЕРСОНАЖЕЙ. А именно, при описании поколений, предшествующих поколению с номером Q, он ничего не говорит о персонажах этого поколения, так как они еще не родились. Затем, при описании поколения Q, летописец именно здесь больше всего говорит о персонажах этого поколения, поскольку с ними напрямую связаны описываемые им события. Очевидно, некоторые из них будут встречаться и дальше, летописцы будут ссылаться на царей и героев предыдущих эпох, но все реже и реже. Наконец, переходя к описанию последующих поколений, летописец все реже упоминает о прежних персонажах, так как описывает новые события, персонажи которых вытесняют умерших. Здесь важно подчеркнуть, что рассматриваются не какие-то отдельные имена, а ПОЛНЫЙ РЕЗЕРВУАР ВСЕХ ИМЕН, использовавшихся в поколении с номером Q. Рассмотрим группу ВСЕХ имен, впервые появившихся в тексте, в "главе-поколении" с номером Q. Условно назовем эти имена Q-именами, а соответствующие им персонажи Q-персонажами. Количество ВСЕХ упоминаний, с кратностями, ВСЕХ этих имен в данной "главе" обозначим через K(Q,Q). Подсчитаем затем, сколько раз эти же имена упомянуты в "главе" с номером Т. Получившееся число обозначим через K(Q,T). При этом, если одно и то же имя повторяется несколько раз, то есть с кратностью, то ВСЕ эти упоминания подсчитываются. Построим график, отложив по горизонтали номера "глав", а по вертикали - числа K(Q,T), где номер Q - фиксирован, а T - меняется. Для каждого Q мы получаем свой график. Принцип затухания частот тогда формулируется так.
Этот график можно назвать идеальным. Сформулированный принцип должен быть проверен экспериментально. Если он верен и если "главы" в летописи упорядочены хронологически правильно, то все экспериментальные графики должны быть близки к идеальному. Проведенная экспериментальная проверка полностью подтвердила принцип затухания частот [904], [908]. Приведем некоторые типичные примеры.
Все графики K(Q,T) для частей "Истории", описывающих периоды 750-500 годы до н.э. и 510-293 годы до н.э., оказались практически тождественными с идеальным. То есть, подавляющее большинство имен, впервые появившихся в описании Тита Ливия в каком-то поколении, наиболее часто упоминаются Титом Ливием при описании именно этого поколения, а затем постепенно утрачиваются, забываются. Следовательно, принцип затухания частот подтверждается, и относительный порядок "глав-поколений" внутри указанных частей "Истории" Тита Ливия скорее всего хронологически правилен. И напротив, при сравнении двух указанных частей текста Тита Ливия друг с другом, обнаруживается, что здесь принцип затухания частот НЕ ВЫПОЛНЯЕТСЯ. Это может указывать, что внутри "Истории" Тита Ливия присутствуют дубликаты, повторы. ПРИМЕР 2. Liber Pontificalis, см. [196], изд. Т.Моммзена, Gestorum Pontificum Romanorum, 1898. Это - известная "Книга (римских) Пап (понтифексов)". Выделим из этого набора текстов куски, описывающие периоды: 1) 300-560 годы н.э., 2) 560-900 годы н.э., 3) 900-1250 годы н.э., 4) 1250-1500 годы н.э. Оказывается, все частотные графики K(Q,T) для указанных текстов 1-4 практически совпадают с идеaльным, что подтверждает принцип затухания частот и правильность относительного расположения "глав" внутри каждого из перечисленных исторических фрагментов. ПРИМЕР 3. В качестве текста Х, описывающего период 976-1341 гг. н.э. в истории Византии, мы взяли следующие первоисточники: 1) Михаил Пселл, "Хронография", М., 1987. Описывает период 976-1075 годы. 3) Иоанн Киннам, "Краткое обозрение царствования Иоанна и Мануила Комнинов" (1118-1180 годы), СПБ, 1859. Все эти тексты были обработаны, из них были выделены все собственные имена и подсчитано распределение частот их упоминаний. Указанный набор текстов содержит несколько десятков тысяч упоминаний полных имен, с кратностями. Оказалось, что все частотные графики K(Q,T) на интервалах 976-1200 годы и 1200-1341 годы практически тождественны с идеальным. Таким образом, и здесь принцип затухания частот оказался выполненным. А с другой стороны, выяснилось, что хронологический порядок текстов внутри каждого из указанных интервалов времени ПРАВИЛЕН. ПРИМЕР 4. Ф. Грегоровиус, "История города Рима в средние века", СПБ, тт.1-6, 1902-1912. Из этого текста были выделены куски, описывающие: 1) 300-560 годы н.э., Каждый из фрагментов был разбит на "главы-поколения". Выделены все собственные имена и прослежены частоты их упоминаний. Полный резервуар имен насчитывает здесь несколько десятков тысяч упоминаний. Оказалось, что принцип затухания частот верен и упорядочивание "глав" в каждом из текстов 1-4 хронологически правильно. 1) 600-1000 годы н.э.,
Оказывается, аналогичная картина затухания наблюдается и для столбцов матрицы. Это означает, что частота употребления в "главе" X(Q) имен более раннего происхождения "в среднем" тоже падает по мере удаления поколения T, породившего эти имена, от фиксированного поколения Q. Конечно, экспериментальные графики могут не совпадать с теоретическим. Методика применима и тогда, когда рассматриваются не все имена, а только одно или несколько имен, например, какие-либо "знаменитые имена". Но в этом случае требуется дополнительный анализ, поскольку уменьшение числа используемых имен делает результаты неустойчивыми.
Пусть интервал времени (А,В) описан в летописи Х, разбитой на "главы-поколения" Х(Т). Пусть они в целом занумерованы хронологически верно, НО СРЕДИ НИХ ЕСТЬ ДВА ДУБЛИКАТА, то есть две "главы", говорящие об одном и том же поколении, дублирующие, повторяющие друг друга. Рассмотрим простейшую ситуацию, когда одна и та же "глава" встречается в летописи Х ровно два раза, а именно, с номером Q и с номером R. Пусть Q меньше R. Наша методика позволяет обнаружить и отождествить эти дубликаты. В самом деле, ясно, что частотные графики K(Q,T) и K(R,T) имеют вид, показанный на рисунке:
Первый график явно не удовлетворяет принципу затухания частот. Поэтому нужно переставить "главы" внутри летописи Х, чтобы добиться лучшего соответствия с теоретическим, идеальным графиком. Все числа K(R,T) равны нулю, так как в "главе" X(R) нет ни одного "нового имени" - все они уже появились в X(Q). Ясно, что наилучшее совпадение с идеальным графиком получится тогда, когда мы поместим эти два дубликата рядом или просто отождествим их. Итак, если среди "глав" летописи, в целом занумерованных правильно, обнаружились две "главы", графики которых имеют приблизительно вид графиков на рисунке выше, то эти "главы", скорее всего, являются дубликатами. То есть, говорят примерно об одних и тех же исторических событиях, и их следует отождествить. Все сказанное переносится на случай, когда есть несколько дубликатов - три и более. Эта методика также была проверена на экспериментальном материале. В качестве простого примера было взято издание "Истории Флоренции" Макьявелли 1973 года (Ленинград), снабженное развернутыми комментариями. Ясно, что комментарии можно рассматривать как серию "глав", дублирующих основной текст Макьявелли. Основной текст был разбит на "главы-поколения", что позволило построить квадратную частотную матрицу КТ, охватывающую и комментарий к "Истории". Эта матрица имеет вид:
где жирные наклонные отрезки состоят из клеток, заполненных максимумами. Это означает, что наша методика успешно обнаруживает известные дубликаты. В данном случае - комментарии к основному тексту "Истории" Макьявелли. При более тщательном анализе используется понятие "возраст имени" - число глав-поколений с момента первого появления такого же имени в тексте. Оказалось, что имена можно разделить на два класса - "вечные" (около 1/4 имен) и "обычные". В соответствии с принципом затухания частот возраст "обычных" имен сохраняет приблизительно постоянное значение (со случайным разбросом вокруг него). Возраст же "вечных" имен постоянно растет со временем (по линейному закону). Следовательно, средний возраст имен естественно описывать линейной регрессией. Дубликат будет выражаться резким поднятием части графика на одну и ту же величину. Как выражается А.Т.Фоменко, возникает характерная "полка", высота которой соответствует расстоянию между дубликатами. Обнаружить такие "полки" можно чисто формально, как отклонения графика от линейной зависимости. Для этого используют алгоритмы обнаружения разладки, те же, что и для обнаружения разладки технологического процесса в рамках статистических методов управления качеством продукции. Список литературы для особо интересующихся: http://chronologia.org/lit7a.html, http://chronologia.org/lit7a.html, http://chronologia.org/lit7c.html, http://chronologia.org/lit7d.html (в тексте ссылки на литературу приведены без изменений) Источник: http://chronologia.org/xpon1/05.html Поделитесь с друзьями: Смотрите также:новая хронология
Автор статьи запретил комментирование незарегистрированными пользователями. Пожалуйста, зарегистрируйтесь или авторизуйтесь на сайте, чтобы иметь возможность комментировать.
|
|||